ATLAS / DEVOPS E ENGENHARIA DE ENTREGA / FABRÍCIO CASTRO
O deploy não encerra.
A responsabilidade continua.
DevOps não é sinônimo de uma ferramenta de CI, Docker ou uma pessoa com acesso ao servidor. É uma abordagem de colaboração e feedback que liga descoberta, desenvolvimento, testes, entrega segura, operação e recuperação. Toda etapa precisa de evidência proporcional ao risco.
01 / DA HIPÓTESE AO SERVIÇO OPERÁVEL
Automação sem método só acelera decisões ruins.
Considere o sistema fictício de aprovação de compras apresentado nas páginas de Requisitos e Arquitetura. Um novo limite de aprovação afeta regra, persistência, API, UX, segurança, documentação e operação. A esteira deve preservar esses contratos e permitir recuperar o serviço se a nova versão falhar.
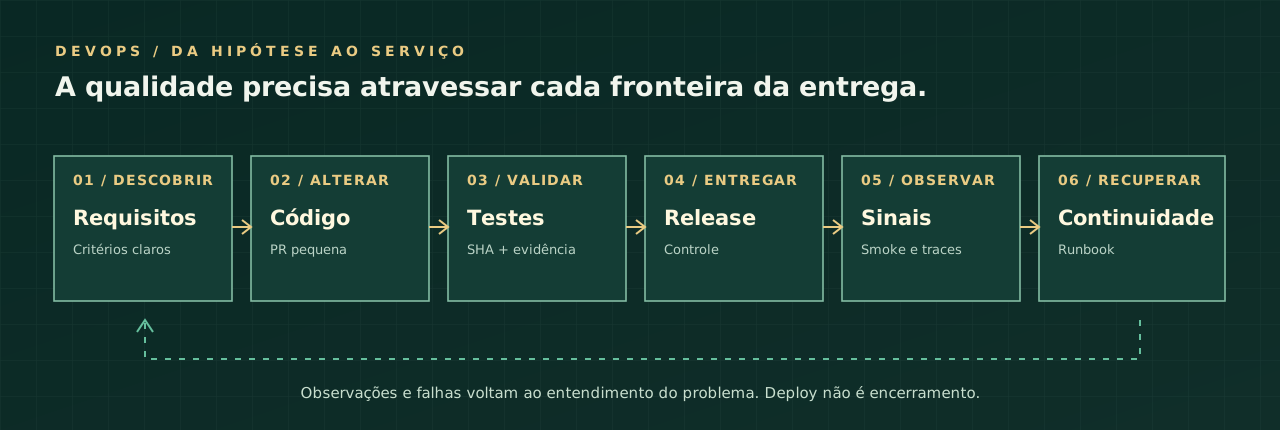
Quem deve ser capaz de explicar a entrega?
Produto define resultado e aceite. Engenharia implementa e testa. Segurança revisa ameaças e segredos. Plataforma oferece ambientes e logs. Operação identifica impacto e recuperação. As pessoas podem acumular papéis, mas a responsabilidade precisa estar explícita.
Resultado: uma mudança pequena, compreensível e reversível, com riscos conhecidos e pessoas responsáveis.
Uma quota bloqueada não vira teste aprovado.
Se o provedor restringe builds, a equipe pode validar contratos e código localmente, registrar `NOT_RUN` para os gates restantes e evitar promover a versão. Comprar um serviço ou repetir builds sem diagnóstico não substitui planejamento financeiro ou comprovação técnica.
Limite: os exemplos desta página não executam GitHub Actions, Vercel, Railway, bancos nem qualquer deploy real.
02 / MAPA DE DISCIPLINA / OPS-01…OPS-14
Quatorze frentes que se conectam. Nenhuma vive isolada.
O roteiro completo está organizado em quatro fases, cada uma com responsabilidades, mecanismos e erros frequentes. São unidades de aprendizagem no currículo — não quatorze URLs ou quatorze módulos já executados.
Descobrir e planejar
Fluxo de valor e colaboração
Aplicação: Investigar onde uma demanda aguarda validação, revisão ou liberação; reduzir filas antes de automatizar.
Erro a evitar: Um dashboard de deploy não substitui entendimento do processo nem diálogo com usuários.
Git, branches e PRs atômicas
Aplicação: Uma mudança deve carregar objetivo, SPEC, evidência, revisão e reversão proporcionais ao risco.
Erro a evitar: Uma PR gigante mistura causas, dificulta revisão, rollback e atribuição de falhas.
Construir e validar
Lockfile e dependências reproduzíveis
Aplicação: pnpm e lockfile versionado devem produzir resolução de dependências verificável no ambiente suportado.
Erro a evitar: Lockfile inventado ou reconstruído sem rede/evidência mascara drift da cadeia.
CI e quality gates
Aplicação: Executar lint, typecheck, unitários, integração, segurança e contratos com saída associada ao SHA.
Erro a evitar: Workflow verde que pulou testes ou executou mocks no lugar do banco exigido é evidência fraca.
Supply chain, SBOM e proveniência
Aplicação: Examinar origem, atualização, vulnerabilidades, artefatos e assinatura quando houver ferramenta disponível.
Erro a evitar: Scanner isolado ou SBOM gerado sem rastreio não prova software seguro em produção.
Segredos e identidade da esteira
Aplicação: Usar identidades de curto prazo, mínimo privilégio, separação por ambiente e rotação segura.
Erro a evitar: Não imprimir secrets em logs nem compartilhar credenciais entre runners e produção.
Implantar e recuperar
CD, promoção e artefatos
Aplicação: Separar compilação, testes, artefato identificável, ambiente de revisão e autorização de promoção.
Erro a evitar: Build local ou commit em Main não comprova deploy acessível, rollback ou smoke.
Containers e isolamento
Aplicação: Docker encapsula processo/dependências e facilita ambiente de testes quando há necessidade operacional.
Erro a evitar: Containers não substituem VMs por definição nem dispensam patch, segredos ou configuração.
Cloud e responsabilidade compartilhada
Aplicação: Comparar Vercel, Railway, VM e serviços gerenciados por requisitos, operação e custo real.
Erro a evitar: Kubernetes e múltiplas clouds não são uma etapa inevitável de todo projeto.
IaC e configuração auditável
Aplicação: Definir recursos, acesso, limites e alterações reproduzíveis e revisadas sob controle de versão.
Erro a evitar: Ferramenta de IaC não evita mudança destrutiva se preview, plano e aprovação forem ignorados.
Migrações de banco sem interrupção
Aplicação: Aplicar expand-contract e compatibilidade de aplicação/esquema com rollback possível ou estratégia alternativa.
Erro a evitar: Rollback de código não reverte automaticamente DDL nem desfaz perda de dados.
Release, flags e rollback
Aplicação: Definir gatilho de pausa, responsáveis, verificação pós-deploy, plano de recuperação e condição de reversão.
Erro a evitar: Promover versão pelo horário ou por status visual sem evidência de serviço é arriscado.
Medir e evoluir
DORA e fluxo de entrega
Aplicação: Medir lead time, frequência, recuperação após falha de deploy, change fail rate e rework rate conforme definições atuais.
Erro a evitar: Não comparar pessoas por contagem de commits nem chamar cinco métricas de SLA ou produtividade individual.
FinOps e limites de quota
Aplicação: Tratar duração, orçamento, limites de build, armazenamento, disponibilidade de runner e manutenção como requisitos.
Erro a evitar: Repetir build bloqueado ou comprar infraestrutura sem comprovar necessidade não melhora a entrega.
03 / INTEGRAÇÃO CONTÍNUA E CONFIANÇA
Um status verde deve corresponder a uma prova.
Uma PR contém mudança, especificação, critérios, testes e revisão. A CI executa gates automatizados em código que representa o commit revisado; não substitui revisão de produto, segurança, visual ou arquitetura. Sempre distinguir falha funcional de erro de infraestrutura e de quota bloqueada.
- 01Identificar objetivo e riscos
Branch pequena, issue/SPEC, fonte do requisito, dados de teste seguros e plano de rollback. Sem esse contexto, a automação apenas repete comandos.
- 02Congelar resolução de dependências
Lockfile e versões suportadas; rejeitar manipulação manual de hashes e instalação silenciosa de dependências. O artefato final deve corresponder à revisão do código.
- 03Executar níveis complementares de teste
Lint e typecheck detectam categorias diferentes das verificadas por Jest, teste de contrato, PostgreSQL real, browser, Axe e testes adversariais. Mock não prova concorrência transacional.
- 04Registrar a evidência
Uma saída precisa apontar para SHA, execução, ambiente e logs. `NOT_RUN`, `BLOCKED` e `FAIL` são diferentes; nenhum deles equivale a `PASS`.
# Exemplo orientativo, NÃO executado nesta página.
pnpm install --frozen-lockfile
pnpm --filter fanpage-frontend test:atlas:contract
pnpm --filter fanpage-frontend test:patterns:unit
pnpm --filter fanpage-frontend type-check
# O build e o browser devem rodar quando houver ambiente/recursos.
# Registrar SHA, ambiente, logs reais e resultado de cada gate.
Sequência ilustrativa para ambiente que tenha pnpm e dependências válidas. Não foi executada para escrever esta página. `next build` e navegador exigem seus próprios gates e recursos.
04 / ENTREGA, PERSISTÊNCIA E RISCO
A aplicação muda. Os dados precisam sobreviver.
CD é controle de promoção e verificação de serviço, não apenas `git push`. Uma migração destrutiva pode impossibilitar rollback de código. Por isso, alterações de esquema e contrato precisam de compatibilidade planejada, especialmente quando aplicações e consumidores não atualizam simultaneamente.
Migrar dados sem depender da sorte.
Primeiro acrescente novas estruturas compatíveis; depois atualize escrita/leitura, migre dados com prova e monitore; só remova o campo antigo após comprovar que consumidores não o usam. O caminho concreto varia com risco, transações e versão do PostgreSQL.
Limite: um rollback de aplicação não desfaz automaticamente uma alteração de dados.
Reverter o software sem perder integridade.
Defina antes: responsáveis, como pausar tráfego, se é possível reverter artefato, compatibilidade de banco, feature flag, backup/restore ensaiado e condição de disparo. Em operações financeiras, reversão de negócio pode precisar compensação registrada, não um simples rollback técnico.
Conhecer o artefato que será promovido.
Dependências auditadas, proveniência, scan e SBOM melhoram transparência, mas não garantem segurança. Um pacote não revisado ou um segredo no CI compromete a esteira independentemente de quantos testes passaram.
Escolher infraestrutura que a equipe consegue operar.
Containers padronizam empacotamento e testes, enquanto provedores gerenciados transferem parte da operação. Não confundir responsabilidade compartilhada com eliminação de responsabilidades nem adotar Kubernetes sem motivo mensurável.
05 / SRE / OPERAR É VERIFICAR
Depois da promoção, o sistema pode discordar do pipeline.
O deploy pode ter sucesso técnico e falhar ao processar pedidos. Por isso, smoke, métricas e monitoramento de negócio acontecem depois que a versão está disponível no ambiente de destino. Um runbook precisa permitir detectar, isolar, recuperar e confirmar o resultado.
- 01Identificar o incidente
Em um cenário fictício, aprovações persistem localmente, mas não chegam ao ERP. Correlacione traces, erros de integração, profundidade da fila e estado visível ao usuário sem registrar dados pessoais desnecessários.
- 02Conter o impacto
Conforme desenho e permissão, pausar consumo, bloquear repetição indevida, reverter alteração incompatível ou ativar fluxo degradado. Não executar compensação automática de compra sem requisito de negócio.
- 03Recuperar e reconciliar
Verificar duplicações, erros permanentes, idempotency keys e contratos de evento. Confirmar que o estado do ERP e o estado local obedecem à política aprovada.
- 04Aprender com evidências
Registrar linha do tempo, hipótese, fatores contribuintes e ação preventiva. A revisão sem culpabilização melhora processo, teste, comunicação e limites de alerta.
06 / DORA / DESEMPENHO DE ENTREGA
Medir fluxo e estabilidade. Não classificar pessoas.
A pesquisa DORA evoluiu de quatro métricas históricas para cinco indicadores de entrega, organizados em throughput e instabilidade. A definição em uso inclui taxa de retrabalho em deploys; ela não é o mesmo que confiabilidade operacional ou percentual de linhas cobertas por testes.
Change lead time
Tempo entre commit e disponibilização bem-sucedida em produção. Não confundir com duração de toda a descoberta ou do desenvolvimento anterior ao commit.
Deployment frequency
Frequência de mudanças efetivamente implantadas. Deploy rápido e frequente pode ser útil, mas não compensa baixo valor ou incidentes recorrentes.
Failed deployment recovery time
Tempo de recuperação de uma implantação que introduziu falha. Diferente do tempo de resolução de qualquer incidente de rede ou datacenter.
Change fail rate
Proporção de mudanças implantadas que exigem intervenção imediata, como hotfix ou rollback. Requer critério consistente para definir falha.
Deployment rework rate
Proporção de deploys não planejados realizados para corrigir erros de produção. Métrica adicionada em 2024 ao conjunto DORA de entrega.
Sem números inventados.
Compare séries de uma equipe com seu próprio contexto, janelas temporais e definições. A Fanpage não declara medições de DORA de empresas reais nem resultados operacionais coletados.
07 / LABORATÓRIO COM CÓDIGO
Quando falta evidência, a decisão deve bloquear.
O exemplo TypeScript `release-gates.ts` modela uma política fail-closed de release, separando gates antes e depois do deploy. Recebe evidências sintéticas, checa SHA, status e referências e devolve `ready` ou `blocked`. Ele não acessa GitHub nem valida assinatura ou autenticidade de logs — isso pertence à esteira real.
const assessment = assessRelease(
  "pre_deploy",
  commitSha,
  evidenceFromVerifiedPipeline,
);
if (assessment.decision !== "ready") {
  throw new Error(assessment.problems.join("; "));
}
// Simular status "passed" NÃO equivale a validar a origem da prova.Verificar o que existe agora.
Lint, TypeScript, unitários, integração, segurança, build, navegador, acessibilidade e plano de reversão são exigidos na política didática. Um `blocked` da Vercel continua bloqueado, mesmo que outros resultados estejam verdes.
Provar o comportamento do ambiente real.
Somente após a implantação cabe executar smoke de rotas e monitorar sinais do serviço. Não é coerente marcar smoke de produção como aprovado antes de uma publicação efetiva.
Falhar de maneira explícita.
A suíte Jest exige bloqueio por gate ausente, build bloqueado, falha, `not_run`, SHA divergente, referência vazia e evidência duplicada. Um conjunto sintético de `passed` valida lógica local, não uma entrega real.
Uma função booleana não substitui aprovação.
Verificar origem das evidências, política institucional, segregação de funções, segredos e resultado de negócio ainda exige controles no servidor e revisão da equipe; o código do laboratório não serve como autorização de deploy.
08 / REFERÊNCIAS E PRÓXIMOS ESTUDOS
Prática documentada, evidência rastreável.
Os estudos são independentes das escolhas de fornecedor e das quotas disponíveis. A documentação a seguir fundamenta critérios atuais, enquanto os scripts do laboratório permanecem exemplos didáticos até execução real.
DORA — evolução das métricas de entrega.
As cinco métricas de throughput/instabilidade, suas definições e evolução histórica, incluindo deployment rework rate em 2024.
GitHub — documentação de workflows.
Eventos, permissões, runners, artefatos e segurança de CI devem ser avaliados conforme contexto e plano disponível. Um exemplo YAML não garante execução gratuita.
OWASP — Software Assurance Maturity Model.
Referencial para evolução de práticas de segurança de desenvolvimento com avaliação e melhoria contínua, não certificado automático pela presença de ferramentas.
Revisar causa, fronteira e efeito.
A arquitetura trata os limites e atributos de qualidade; Design Patterns organiza estruturas de código. DevOps verifica se essas escolhas sobrevivem à entrega, operação e mudança.
Situação editorial: capítulo integrado a uma branch de desenvolvimento. Código de referência e testes estão escritos, mas typecheck, testes de runtime, QA visual, deploy e incidentes reais não foram executados nesta etapa.